ChatGPT(チャットGPT)はオフラインでは使えない——ローカルLLMなど機密情報を守る4つの方法と選び方【2026年版】

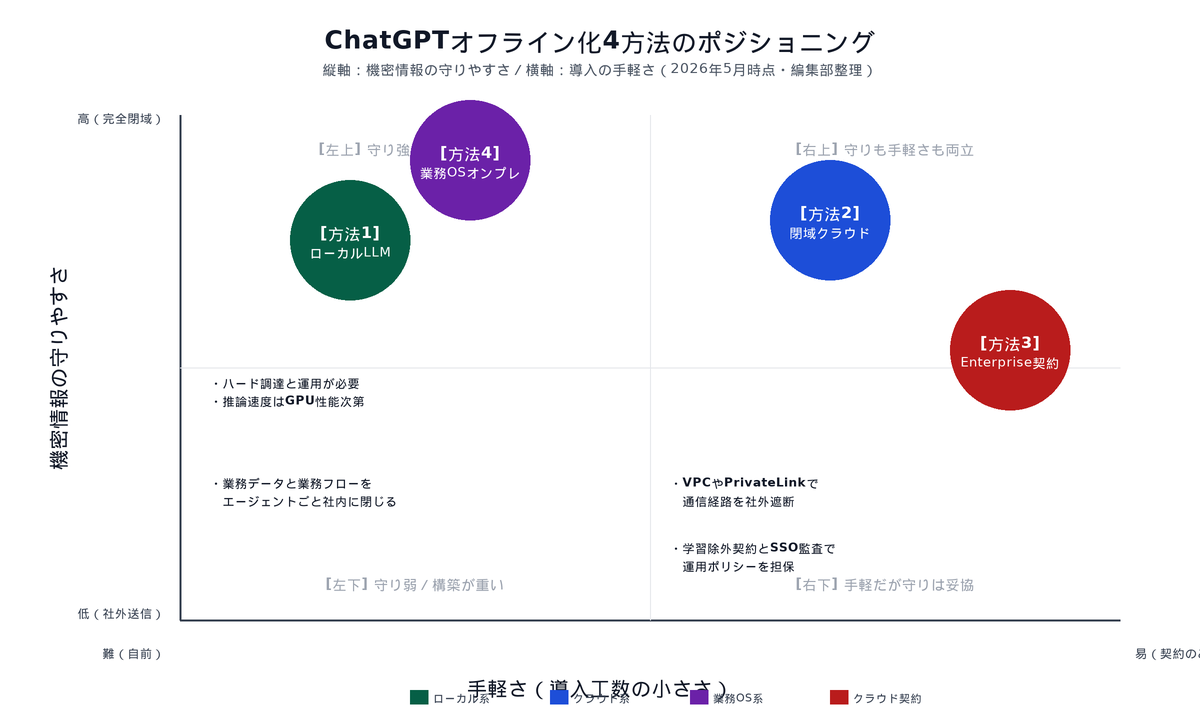
結論からいえば、ChatGPT(チャットGPT)本体はクラウド型サービスのため、インターネット接続を切った完全オフラインでは動作しません。ただし製造業の実務で求められる「オフライン」は多くの場合「設計図面や顧客情報を社外サーバーに送信しないこと」であり、これはローカルLLM・閉域クラウド・エンタープライズ契約・業務OSオンプレ運用の4つの方法で実現できます。本稿では2026年7月時点の選択肢を、機密情報の守りやすさと導入の手軽さで比較します。
この記事の要点
- ChatGPT本体(Web版・スマホアプリ・デスクトップアプリ)はクラウド側で推論するため、完全オフラインでは動作しない
- 「社外にデータを出さない」運用は、①ローカルLLM ②閉域クラウド ③エンタープライズ契約 ④業務OSオンプレ運用 の4つの方法で実現できる
- 機密データを社内に閉じる必要があるなら方法1か方法4、契約と監査で守れれば十分なら方法2か方法3
- 導入が最も手軽なのは方法3(エンタープライズ契約)で、アカウントを払い出せばその日から使い始められる
- 多くの製造業では「まず方法3で全社展開→機密度の高い本命業務に方法4」の二段構えが現実的
この記事が支援する判断:製造業の情シス・DX推進担当が、社外にデータを出せない業務に生成AIを入れるにあたり、ローカルLLM・閉域クラウド・エンタープライズ契約・業務OSオンプレ運用の4つのどれを選ぶかを決める場面を支援します。ここを決めないままPoCに入ると、機密要件が後から覆って作り直しになります。
ChatGPTはそのままオフラインで使える?
使えません——ChatGPT本体(Webブラウザ版・スマホアプリ・デスクトップアプリ)は、推論処理をOpenAIのクラウドサーバー側で実行するため、ネットワークを遮断した状態では応答できなくなります。したがって「ChatGPTをオフラインで使う」を文字通り実現する方法は存在せず、実務で検討すべきは「ChatGPT相当の生成AIを、社外にデータを出さずに使う」ための代替構成です。
製造業でいう「オフライン」は何を指すのか?
製造業の業務利用で問題になるのは、原理的な通信遮断ではなく「業務データが社外の学習基盤に渡らないこと」「通信経路が社外の不特定多数に晒されないこと」の2点です。エアギャップまで踏み込むのは防衛・原子力など限定用途で、多くの中堅製造業はデータガバナンスを担保できれば実質的なオフライン運用と評価できます。選択肢は大きく次の4つに分かれます。
- 方法1:ローカルLLM——社内サーバーやワークステーションにオープンソースのモデル(Llama 3、Mistral、Gemma 2 など)を導入し、推論を社内完結させる
- 方法2:閉域クラウド——Azure OpenAI ServiceやAmazon Bedrock を VPC・Private Endpoint 経由で接続し、通信経路を社外遮断する
- 方法3:エンタープライズ契約——ChatGPT EnterpriseやClaude for Enterprise、Gemini for Workspace などの「学習除外+監査ログ」型契約を結ぶ
- 方法4:業務OSオンプレ運用——汎用の生成AIではなく、業務エージェント基盤そのものを社内に構築し、業務データと業務フローをまとめて社内に閉じる


オフラインで動くもの・動かないものは?——利用形態別の一覧
「ChatGPTはオフラインで使えるか」の答えは、どの形で使うかによって分かれます。判定の基準は1つで、推論(回答の生成)を自社の端末・サーバーで実行するかどうかです。クラウド側で推論する形はすべて通信が前提になり、モデルそのものを手元に置く形だけが通信なしで動きます。
| 利用形態 | 通信を切って動くか | 推論の場所 | 必要な計算資源の目安 |
|---|---|---|---|
| ChatGPT(Web版・スマホアプリ・デスクトップアプリ) | 動かない | OpenAIのクラウド | —(端末は入口のみ) |
| ChatGPT Enterprise/Business | 動かない | OpenAIのクラウド | —(学習除外は契約で担保) |
| Azure OpenAI Service(閉域接続) | 動かない(経路は社外遮断できる) | 契約クラウド | — |
| gpt-oss-20b(OpenAI公開のオープンウェイトモデル) | 動く | 自社の端末・サーバー | メモリ16GB |
| gpt-oss-120b(同上) | 動く | 自社のサーバー | 80GBクラスのGPU 1枚 |
| Llama・Gemma などのオープンモデル(Ollama 等で実行) | 動く | 自社の端末・サーバー | モデルの規模による |
OpenAI製のモデルならオフラインで動かせるのか?
見落とされやすいのが、OpenAI自身が手元で動かせるモデルを公開している点です。2025年8月に公開された gpt-oss はApache 2.0ライセンスのオープンウェイトモデルで、OpenAIがHugging Faceに掲載した公式モデルカードは、小さい方の gpt-oss-20b について「for lower latency, and local or specialized use cases
(低遅延、ローカル、特化用途向け)」、動作条件を「run within 16GB of memory
(16GBのメモリ内で動作)」と記しています(出典:OpenAI「gpt-oss-20b」モデルカード)。つまり「ChatGPTそのもの」はオフラインで使えないが、「OpenAI製のモデル」を社内で動かすことはできるというのが正確な整理です。これは後述の方法1(ローカルLLM)の選択肢の1つに当たります。
方法1:ローカルLLM——社内完結の王道アプローチ
2024年と比べて2026年で大きく変わったのは、オープンソースモデルの実力がChatGPT-4o相当に近づいたことです。Llama 3.3(70B)、Mixtral、Gemma 2、Phi-3 などは推論用途であれば NVIDIA RTX 4090 1枚〜A100 1枚で実用速度に達します。Ollama・LM Studio・GPT4All・vLLM といった導入ツールも揃い、設計仕様書のドラフト生成・検査記録の要約・社内Q&Aボットといった典型用途であれば社内サーバーで完結します。一方、推論速度はGPU性能に依存し、最新クラウドモデルと比べると応答速度・推論品質に差が残るケースは残ります。
製造現場ではインターネット接続が制限される場合や、機密情報を扱う場面が多く、クラウド型AIサービスには利用上の制約がつきまといます。ローカルLLMは、こうした課題に対する有力な解決策として注目を集めています。
製造業の未来を切り拓くローカルLLMの実力と可能性
方法2:閉域クラウド——通信経路を社外遮断する
クラウドの最新モデルを使いつつインターネット経由のデータ送信を避けたい場合は、閉域接続型クラウドが応えます。代表的なのは Microsoft Azure OpenAI Service を Azure Private Link で専用線経由にする構成、Amazon Bedrock を VPC エンドポイント経由で Claude・Llama・Mistral・Amazon Titan に閉域接続する構成、Google Vertex AI を VPC Service Controls で境界制御する構成の3系統です。入力データはモデル学習に使われない契約条項が標準で付帯し、GPT-4o・Claude 3.5 Sonnet・Gemini 2.0 Pro といった最新モデルをそのまま使えます。導入の難所はネットワーク設計と権限管理で、情シス部門に VPC・IAM の設計知見があるかが成否を分けます。
方法3:エンタープライズ契約——契約と監査で守る
3つ目は SaaS型の生成AIをそのまま使いつつ、契約レベルでデータガバナンスを担保するアプローチです。代表は ChatGPT Enterprise/Business、Claude for Enterprise、Gemini for Google Workspace の3系統で、入力データの学習除外、SSO認証、管理者監査ログ、リテンション調整が標準で付帯します。導入の手軽さは4方法中最大で、社員にアカウントを払い出せばその日から使い始められます。一方、データは契約サーバーに送信されるため機密情報を「物理的な閉域」ではなく「契約と監査と運用ポリシー」で守る割り切りが必要です。試行期はまず方法3で始め、業務適用範囲が広がってから方法1・2・4を検討する段階的アプローチが現実的です。
生成AI の利用にあたっては、入力情報がどう扱われるかをサービスごとに確認することが第一歩になります。学習データへの取り込み有無、保存期間、削除ポリシーは、各社の利用規約とエンタープライズ契約で明示されています。
生成AIのセキュリティ-現状の課題と解決策
方法4:業務OSオンプレ運用——業務エージェントごと社内に閉じる
4つ目は方向性が他の3つと大きく異なります。汎用の対話型生成AIを社内で動かすのではなく、業務エージェント基盤そのものを社内構築するアプローチです。設計・調達・品質・生産技術それぞれの業務にあわせたエージェント(業務OS)を、社内の図面・部品表・検査記録・サプライヤー情報と連携した形で動かします。背後の言語モデルはローカルLLM・閉域クラウドのどちらを選んでも構いません。重要なのは業務データの所在と業務フローの主導権を社内に置くことで、設計OSなら図面検索・類似案件の自動引き当て・設計変更通知の差分抽出までを一つのエージェントで完結させられます。
ERPは「お金とモノの記録台帳」、PLMは「図面とBOMの保管庫」であり、いずれも「業務そのもの」を実行する仕組みではない。
業務OSとは何か——製造業ERPでもPLMでもない、第3の業務基盤の正体
自社の業務が方法1〜4のどれに向くかを個別に切り分けたい場合は、業務診断(無料・30分)で「業務OSが効く業務/効かない業務」を整理するところから始められます。
4つの方法はどう違う?
| 項目 | 方法1 ローカルLLM | 方法2 閉域クラウド | 方法3 Enterprise契約 | 方法4 業務OSオンプレ |
|---|---|---|---|---|
| 機密データの送信先 | 社内のみ | 契約クラウド/閉域経路 | 契約クラウド/公衆経路 | 社内のみ |
| 初期導入工数 | 大(GPU調達+運用設計) | 中(VPC/IAM設計) | 小(契約+SSO) | 大(業務分解+実装) |
| 運用工数 | 中〜大 | 中 | 小 | 中(伴走前提) |
| 推論品質 | OSSモデル相当 | 最新フロンティアモデル | 最新フロンティアモデル | 選択可(OSS/クラウド) |
| 業務適合度 | 汎用 | 汎用 | 汎用 | 業務特化(高) |
| 向いている用途 | 機密度高・コスト最小化 | 最新モデル+経路遮断 | 試行期・全社展開 | 業務インパクト最大化 |
どの方法を選ぶべき?
- 機密情報の所在は社内に閉じる必要があるか、契約条項で十分か——閉じる必要がある業務なら方法1・2・4、契約条項で十分なら方法3
- 任せたいのは汎用対話か、業務エージェントか——汎用対話なら方法1〜3、業務エージェントなら方法4
- 情シスのネットワーク設計力・GPU運用力は社内にあるか——あるなら方法1・2、難しいなら方法3か方法4の受託活用
多くの中堅製造業では、初期は方法3で全社員にアカウント配布、本命業務(設計OS/調達OS/品質OS/生産技術OS)には方法4を被せる二段構えが現実的です。汎用生成AIで「アシスタント機能」を底上げしつつ、業務エージェントで「業務そのもの」を変える棲み分けです。
ローカルLLMが向かない業務・まだ早い条件とは?
方法1(ローカルLLM)は「社内に閉じられる」点で魅力的に見えますが、次の条件に当てはまる場合は向かないか、少なくとも現時点ではまだ早い判断になります。閉じることの代償は、更新と運用を自社で背負うことだからです。
| 当てはまる条件 | なぜ向かないのか | 代わりに取る手 |
|---|---|---|
| 出力の正しさを誰も検証できない業務 | 誤りに気づけないまま下流の判断に流れる | 人の確認を挟める業務から始める |
| GPUの調達・更新を担う担当が決まっていない | 導入直後は動いても、モデル更新が止まり陳腐化する | 方法2または方法3で運用を外に出す |
| 最新の一般知識を前提にした用途 | ローカルモデルの知識は学習時点で止まる | クラウド型(方法2・3)を使う |
| 利用者を全社に広げる想定 | 同時利用数に応じて計算資源が要り、配布が重くなる | 方法3で配り、機密業務だけ閉じる |
| 対象業務が月に数回しか発生しない | 構築と維持の手間に対して効果が見合わない | 当面は対象外にする |
とくに1行目が実務では重くなります。閉じた環境では外部の目が入らないため、誤りを検出する役目はすべて社内に残ります。検証の担い手を決められない段階では、閉じること自体がリスクになります。
なお、現場でローカルLLMを実際に動かす手順や使用感については、インターネット接続なし、オフラインで使える生成AI!製造業の現場で使えるChatGPTライクなローカルLLM活用方法で扱っています。本記事は「4つの方式のどれを選ぶか」の判断を、そちらは「選んだあとに現場で動かす方法」を担当します。
よくある質問
Q1. ローカルLLMで業務に使えるレベルの精度は出ますか?
Llama 3.3(70B)やMixtral 8x22B クラスなら、社内Q&A・文書要約・仕様書ドラフトなど用途を絞れば実用域に達します。複雑な推論や長文の論理整合性が要求される業務では最新フロンティアモデル(GPT-4o、Claude 3.5 Sonnet)と差が残ります、というのが2026年7月時点の現実的な評価です。
Q2. Azure OpenAI Service と ChatGPT Enterprise の違いは?
違いは「通信経路の制御」と「業務システム統合」です。Azure OpenAI Service は VPC・Private Link で経路を社外遮断でき、自社で構築した社内アプリにAPIとして組み込む前提です。ChatGPT Enterprise は完成されたチャットUIをそのまま社員に配る前提で、業務システムとの統合は限定的です。
Q3. ChatGPTのスマホアプリやデスクトップアプリならオフラインで使えますか?
使えません。アプリはクラウド上のモデルへの入口にすぎず、推論処理はOpenAIのサーバー側で実行されるため、通信を遮断すると応答できなくなります。オフライン相当の運用をしたい場合は、方法1(ローカルLLM)のようにモデル自体を社内環境で動かす構成が必要です。
Q4. 無料でローカルLLMを試す方法はありますか?
Ollama や LM Studio などの無料ツールを使えば、Llama系をはじめとするオープンソースモデルを手元のPCで動かして試せます。ただし業務導入の段階では、GPUリソース・モデルのライセンス条件・運用体制の設計が別途必要になるため、個人の試用と本番導入は分けて考えるのが安全です。
Q5. どの方法から始めるのが現実的ですか?
試行期は、アカウントの払い出しだけで始められる方法3(エンタープライズ契約)が現実的です。そのうえで、機密度の高い本命業務(設計・調達・品質・生産技術)には方法4(業務OSオンプレ運用)を重ねる二段構えにすると、導入の手軽さと機密性を両立できます。
Q6. OpenAIのモデルでオフラインで動くものはありますか?
あります。OpenAIは2025年8月にオープンウェイトモデル gpt-oss を公開しており、公式モデルカードによれば gpt-oss-20b は16GBのメモリ内で、gpt-oss-120b は80GBクラスのGPU 1枚で動作します。モデルを社内の端末・サーバーに置けば通信なしで推論できます。ただしChatGPTのアプリやWeb版がオフラインで動くわけではなく、位置づけは方法1(ローカルLLM)の選択肢の1つです。
次に読むべき記事
- 業務OSとは何か——製造業ERPでもPLMでもない、第3の業務基盤の正体(方法4の概念基盤)
- 情シス部長が現場から殺到する「AI内製依頼」をどう捌くか——5つの失敗パターンとガバナンス設計(社内導入時の組織設計)
- 製造業の未来を切り拓くローカルLLMの実力と可能性(方法1の詳細)
まとめ——自社の業務文脈から逆算する
「ChatGPTをオフラインで使う」という検索意図の背後には、製造業特有の「データを社外に出したくない」守りの意識と「最新の生成AIの実力をそのまま使いたい」攻めの意識が同居しています。両立させる方法は2026年7月時点で本稿の4つに整理でき、機密データの所在ルール・実現したい業務インパクト・情シスの体制という3つの問いから逆算するのが近道です。
出典・参考情報
- OpenAI「ChatGPT Enterprise」公式ページ——入力データをモデルの学習に使用しない旨を明記
- Microsoft Learn「Azure OpenAI のデータ、プライバシー、セキュリティ」——顧客データをモデルの再学習に使用しない旨の公式ドキュメント
- AWS 公式ドキュメント「Amazon Bedrock でサポートされている基盤モデル」
- OpenAI「gpt-oss-20b」モデルカード(Hugging Face)——ライセンス(Apache 2.0)と動作条件(gpt-oss-20b は16GBメモリ、gpt-oss-120b は80GB GPU 1枚)の記載
※上記リンクは2026年7月21日に編集部で到達確認しています(gpt-oss モデルカードのみ2026年9月25日確認)。